Quel modèle
pour votre besoin ?
Coder, lire un document, résoudre un problème… Comparez les résultats selon ce que vous voulez faire.
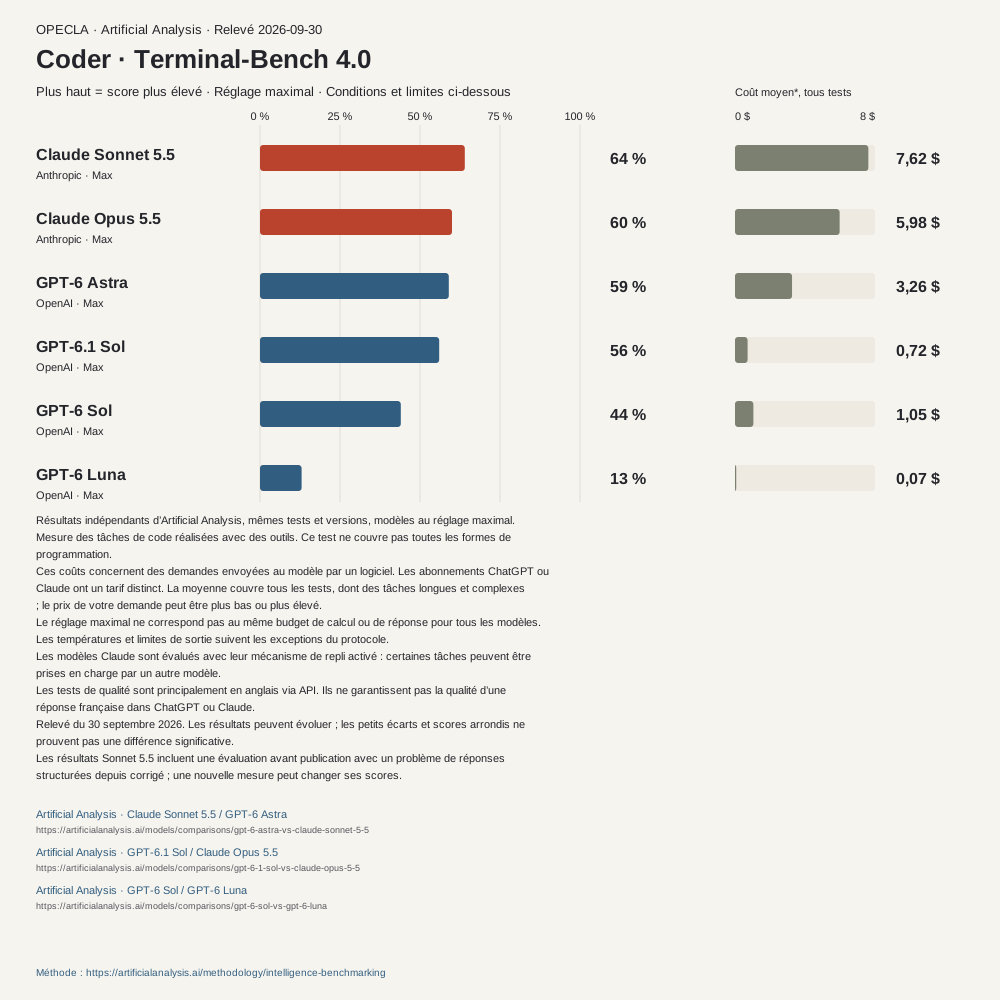
Coder
Créer un site, corriger un bug ou modifier une application.
Lisez le résultat et le coût côte à côte. Le coût est une moyenne sur tous les tests.
Mesure des tâches de code réalisées avec des outils. Ce test ne couvre pas toutes les formes de programmation.
* Coût moyen par tâche, toutes catégories. Ces coûts concernent des demandes envoyées au modèle par un logiciel. Les abonnements ChatGPT ou Claude ont un tarif distinct. La moyenne couvre tous les tests, dont des tâches longues et complexes ; le prix de votre demande peut être plus bas ou plus élevé. Comparer selon votre budget ↗
Le meilleur choix dépend
de votre tâche.
- Partez de votre besoin.Un modèle peut être à l’aise pour coder et moins bon pour lire un document.
- Lisez le score du bon test.64 % signifie 64 % de réussite sur ce test. Cela ne veut pas dire « bon à 64 % dans tous les domaines ».
- Regardez aussi le coût et l’attente.Un score plus haut peut demander plus de temps et plus d’argent.
Voir les chiffres, les réglages et les sources
Test : Terminal-Bench 4.0. Le réglage « Max » donne au modèle davantage de temps pour réfléchir. Il ne correspond pas au même budget pour tous.
| Modèle | Résultat | Coût moyen, tous tests | Conditions | Source |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 64 % | 7,62 $ | Réglage Max. Raisonnement adaptatif ; repli vers un autre modèle activé par défaut. | Résultat chez Artificial Analysis ↗Relevé le 30 septembre 2026 |
| Claude Opus 5.5 | 60 % | 5,98 $ | Réglage Max. Raisonnement adaptatif ; repli vers un autre modèle activé par défaut. | Résultat chez Artificial Analysis ↗Relevé le 30 septembre 2026 |
| GPT-6 Astra | 59 % | 3,26 $ | Réglage Max. Réglage maximal du raisonnement ; budget de sortie propre au modèle. | Résultat chez Artificial Analysis ↗Relevé le 30 septembre 2026 |
| GPT-6.1 Sol | 56 % | 0,72 $ | Réglage Max. Réglage maximal du raisonnement ; budget de sortie propre au modèle. | Résultat chez Artificial Analysis ↗Relevé le 30 septembre 2026 |
| GPT-6 Sol | 44 % | 1,05 $ | Réglage Max. Réglage maximal du raisonnement ; budget de sortie propre au modèle. | Résultat chez Artificial Analysis ↗Relevé le 30 septembre 2026 |
| GPT-6 Luna | 13 % | 0,07 $ | Réglage Max. Réglage maximal du raisonnement ; budget de sortie propre au modèle. | Résultat chez Artificial Analysis ↗Relevé le 30 septembre 2026 |
Comment cette comparaison est faite
Un évaluateur extérieur aux fabricants
Artificial Analysis teste les modèles d’OpenAI, d’Anthropic et d’autres entreprises avec sa propre méthode. Chaque graphique compare un seul test et une seule version de ce test. Nous n’avons pas utilisé les scores publicitaires des fabricants pour remplir ces graphiques.
Des conditions communes, avec des différences à connaître
Résultats indépendants d’Artificial Analysis, mêmes tests et versions, modèles au réglage maximal. Un même réglage ne donne pas exactement le même temps de réflexion à chaque modèle.
- Le réglage maximal ne correspond pas au même budget de calcul ou de réponse pour tous les modèles. Les températures et limites de sortie suivent les exceptions du protocole.
- Les modèles Claude sont évalués avec leur mécanisme de repli activé : certaines tâches peuvent être prises en charge par un autre modèle.
- Les tests de qualité sont principalement en anglais via API. Ils ne garantissent pas la qualité d’une réponse française dans ChatGPT ou Claude.
- Relevé du 30 septembre 2026. Les résultats peuvent évoluer ; les petits écarts et scores arrondis ne prouvent pas une différence significative.
- Les résultats Sonnet 5.5 incluent une évaluation avant publication avec un problème de réponses structurées depuis corrigé ; une nouvelle mesure peut changer ses scores.
Comprendre les unités
« % » indique la réussite définie par le test. « Points » indique un score de comparaison : ce n’est pas un pourcentage. Les dollars représentent des coûts API, c’est-à-dire le coût d’un modèle utilisé par un logiciel, distinct d’un abonnement ChatGPT ou Claude. Les secondes mesurent l’attente. Un « fragment » de texte, appelé token, peut être un mot ou seulement une partie d’un mot.
Méthode des tests de qualité ↗ · Méthode des mesures de vitesse ↗
D’autres analyses utiles
Vals AI ↗ explique aussi ses tests communs et leurs marges d’erreur. Arena ↗ compare les préférences des utilisateurs pour des réponses présentées sans nom de modèle. Ces deux méthodes ne mesurent pas exactement la même chose ; leurs scores ne sont pas mélangés ici.
Les données sont un relevé conservé dans le projet. Cette page ne promet pas une mise à jour automatique.